Fehlerclustering im Softwaretest: Was es ist und wie es funktioniert
Fehlerclustering im Softwaretest bedeutet, dass die meisten Ihrer Bugs aus wenigen Modulen stammen, nicht aus der gesamten Anwendung. Wenn die Hälfte der Defekte in Ihrem letzten Release aus zwei Modulen kam, ist das Clustering, und deshalb verteilen erfahrene QA-Teams ihre Anstrengungen nicht gleichmäßig. Sobald Sie wissen, welche Module die Probleme verursachen, wissen Sie, wo Sie härter testen müssen und was Sie zuerst in der Regression ausführen sollten.
Fehlerclustering bedeutet, dass ein kleiner Anteil Ihrer Module die meisten Ihrer Bugs produziert. Oft sitzen 70 bis 90% der Defekte in wenigen Modulen, nahe einer 80/20-Aufteilung.
Login, Zahlungen und alles, was eine externe API aufruft, sind die üblichen Verdächtigen. Sie sind komplex, ändern sich oft und hängen von Systemen ab, die Sie nicht kontrollieren.
Um Cluster zu finden, exportieren Sie Defekte aus Ihrem Tracker, zählen Sie sie nach Modul und vergleichen Sie die Fehlerdichte, damit große und kleine Module fair beurteilt werden.
Testen und automatisieren Sie die geclusterten Module zuerst. Stabiler Code braucht eine leichtere Hand.
Clustering spiegelt nur vergangene Bugs wider. Ein Modul mit wenigen Defekten ist möglicherweise einfach ungetestet, also schreiben Sie es nicht ab.
Wenn 80% Ihrer Abstürze aus 20% Ihres Codes kommen, verschwendet gleichmäßiges Testen aller Bereiche Zeit. So finden Sie diese 20% und setzen sie gewinnbringend ein.
Was ist Fehlerclustering im Softwaretest?
Fehlerclustering ist das Muster, bei dem eine kleine Gruppe von Modulen die meisten Defekte einer Anwendung enthält, normalerweise 70 bis 90% davon. Stellen Sie sich vor, Sie finden jede fehlende Socke in einer Ecke des Trockners. Die Bugs sind nicht über die gesamte Ladung verteilt.
Das ist die Definition von Fehlerclustering, mit der die meisten QA-Teams arbeiten. Die Bedeutung von Fehlerclustering in der Praxis ist einfach: Mancher Code bricht viel öfter als anderer Code. Vielleicht ist es das Payment-Gateway, das dieses Jahr sechsmal gepatcht wurde. Vielleicht ist es die Suchfunktion, die drei Entwickler seit dem Frühjahr neu geschrieben haben. Ihre eigene Bug-Historie zeigt Ihnen, welche das sind, sodass Sie nicht raten müssen.
Also, was ist Fehlerclustering in einfachen Worten? Ein Planungswerkzeug. Die wackeligen Module bekommen mehr Testabdeckung und mehr explorative Zeit. Die ruhigen Legacy-Module, die seit zwei Jahren keine Bugs hatten, bekommen einen schnellen Smoke-Test und werden in Ruhe gelassen. So verwandelt Fehlerclustering im Testprozess einen Haufen Fehlerberichte in einen Plan.
Das Prinzip hinter Fehlerclustering
Das Prinzip des Fehlerclustering stammt vom Pareto-Prinzip, der 80/20-Regel: Ungefähr 80% der Defekte kommen aus 20% der Module. Das Verhältnis verschiebt sich. Einige Projekte landen bei 70/30, andere bei 90/10. Die Form bleibt gleich.
Zwei Dinge treiben es an. Das erste ist Komplexität. Ein Modul, das Geschäftsregeln verarbeitet und mehrere APIs aufruft, hat weitaus mehr Stellen zum Brechen als eine Einstellungsseite. Das zweite ist Veränderung. Jede Bearbeitung eines viel genutzten Moduls kann etwas kaputt machen, das gestern funktionierte. Deadlines verschlimmern es, da ein Feature, das von einem müden Team herausgebracht wurde, normalerweise mehr Bugs trägt als eines, das mit Zeit gebaut wurde.
Die Prinzipien des Fehlerclustering-Tests handeln von Mustern, nicht von Menschen. Wenn ein Modul Ihren Tracker ständig füllt, behandeln Sie das als Information. Es braucht möglicherweise ein Refactoring oder eigene Integrationstests oder einfach einen zweiten Reviewer bei jedem Pull Request. Die Daten lassen Sie das mit Beweisen verlangen.
Beispiele für Fehlerclustering
Ein typisches Beispiel für Fehlerclustering sieht so aus: dieselben wenigen Bereiche füllen Ihre Bug-Liste bei jedem Release. Das sind die, die Teams am häufigsten melden:
Login und Authentifizierung – OAuth, Session-Handling und Token-Ablauf müssen alle zusammenarbeiten, und gesperrte oder abgelaufene Konten fügen Sonderfälle hinzu. Ein SaaS-Produkt kann feststellen, dass 60% seiner kritischen Defekte auf Login zurückgehen.
Zahlungen und Checkout – Geldlogik lässt wenig Raum für Fehler. Währungsumrechnung und Steuerregeln interagieren mit Rabattcodes und Rückerstattungen, und Gateway-Timeouts fügen weitere Fehlerpunkte hinzu. Ein Bug kann Einnahmen blockieren, deshalb bemerken E-Commerce-Teams diesen Cluster zuerst.
Drittanbieter-API-Integrationen – Sie hängen von der Uptime und dem Schema eines anderen ab. Wenn ein Mapping- oder E-Mail-Service ein Feld umbenennt oder ein Rate-Limit erreicht, bricht Ihr Feature und der Bug landet in Ihrem Tracker.
Suche und Filterung – Query-Parsing, Ranking, Paginierung und Last beeinflussen alle Ergebnisse. Benutzer suchen ständig, also melden sie diese Bugs schnell.
Admin-Dashboards und Reporting – Diese werden spät gebaut und leicht getestet, dann pushen Power-User sie auf Weisen, die niemand geplant hat. Ein Reporting-Modul kann mit der Hälfte der Produktionsbugs eines Produkts enden.
Mobile-spezifische Module – Push-Benachrichtigungen, Offline-Sync und biometrischer Login hängen von Gerätehardware und OS-Berechtigungen ab, die Sie nicht vollständig kontrollieren können.
Jedes Beispiel für Fehlerclustering läuft auf komplexe Logik hinaus, die sich oft ändert und von anderen Systemen abhängt. Wenn Sie diese Kombination in Ihrem eigenen Produkt sehen, beginnen Sie dort.
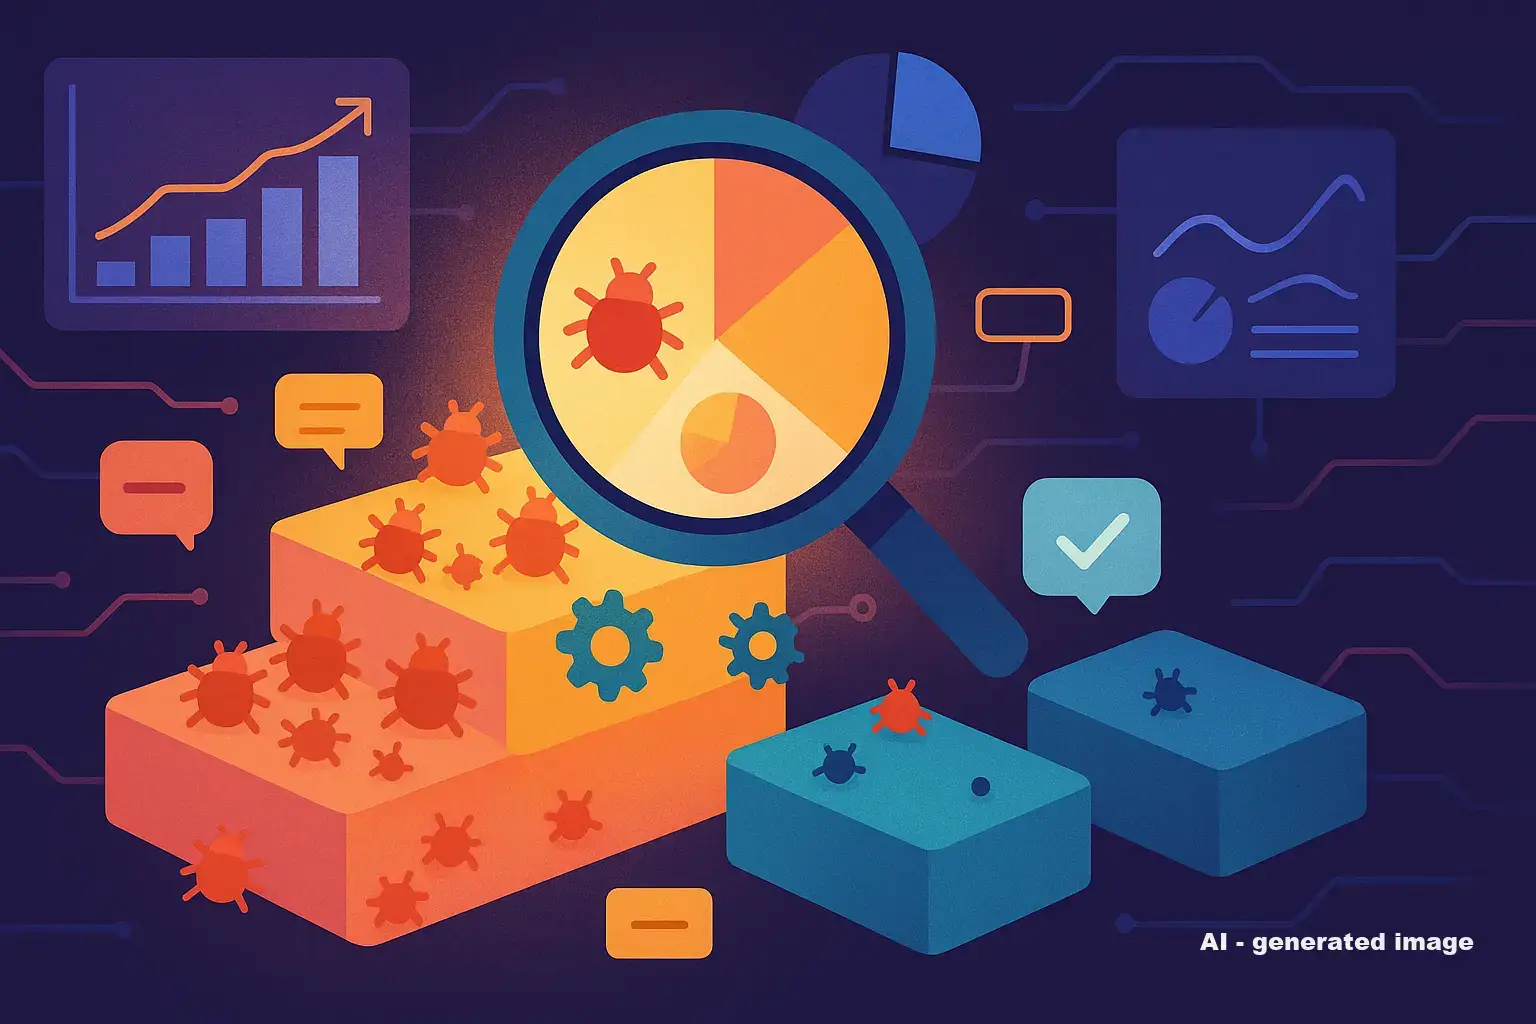
Das Erkennen von Fehlerclustern ist nur die halbe Miete. Die eigentliche Herausforderung besteht darin, über die richtigen Tools zu verfügen, um Muster zu visualisieren, diese im Zeitverlauf zu verfolgen und auf der Grundlage der gewonnenen Erkenntnisse zu handeln. aqua cloud setzt die Fehlerclusterung von der Theorie in die Praxis um – mit anpassbaren Dashboards, die Ihnen sofort zeigen, wo sich Fehler über Module, Komponenten und Schweregrade hinweg konzentrieren. Visualisieren Sie die Fehlerverteilung mit Kreisdiagrammen, verfolgen Sie Trends im Zeitverlauf mit Burndown-Analysen und gehen Sie mit dynamischen Filtern detailliert auf Hotspots ein – alles in Echtzeit. Die bidirektionale Jira-Integration von aqua stellt sicher, dass Ihre Clusteranalyse teamübergreifend synchronisiert bleibt, während Sie mit benutzerdefinierten Feldern und Tags Fehler genau so kategorisieren können, wie es Ihr Projekt erfordert. Darüber hinaus erhalten Sie mit der domänenspezifisch trainierten „aqua Intelligence“, die auf RAG-Grounding basiert und aus der tatsächlichen Dokumentation Ihres Projekts lernt, eine kontextbezogene Testgenerierung, die Ihre bekannten Cluster mit einer Präzision anspricht, mit der generische KI-Tools einfach nicht mithalten können. Hören Sie auf zu raten, worauf Sie Ihre Testbemühungen konzentrieren sollen, und orientieren Sie sich stattdessen an den Daten.
Verwandeln Sie Fehlermuster mithilfe intelligenter Analysen in strategische Testentscheidungen
Sie identifizieren Fehlercluster, indem Sie Defekte pro Modul zählen und prüfen, welche Module die meisten davon enthalten. Exportieren Sie Defekte aus Jira oder GitHub Issues mit einem Modul- oder Komponenten-Tag. Wenn Ihr Tracker nicht nach Modul taggt, fügen Sie Tags von Hand hinzu oder schreiben Sie ein kurzes Script, das Bugs nach Schlüsselwörtern im Titel sortiert.
Ranken Sie dann Module nach Defektanzahl und addieren Sie die Prozentsätze, während Sie die Liste durchgehen. Wenn drei Module 70% aller Defekte abdecken, sind das Ihre Cluster. Ein Balkendiagramm oder Pareto-Diagramm macht dies auf einen Blick offensichtlich. Wiederholen Sie die Übung am Ende jedes Sprints oder Releases, denn ein ruhiges Modul kann direkt nach einem großen Refactoring zum Hotspot werden.
Prüfen Sie als Nächstes die Fehlerdichte, also Defekte pro 1.000 Codezeilen oder pro Function Point. Modul A mit 200 Defekten in 5.000 Zeilen hat die achtfache Dichte von Modul B mit 50 Defekten in 10.000 Zeilen. Die Dichte lässt Sie ein kleines Modul fair mit einem großen vergleichen. Fügen Sie auch den Schweregrad hinzu, denn ein Haufen kleiner UI-Fehler ist ein anderes Problem als ein Haufen Sicherheitslöcher.
Fragen Sie dann Leute. Entwickler wissen, welche Module sie fürchten zu bearbeiten, und der Support weiß, welche Features die meisten Tickets generieren. Diese Antworten weisen oft auf Cluster hin, die Ihre Zahlen noch nicht erfasst haben.
Fehlerclustering vs. Fehlerdichte
Fehlerclustering sagt Ihnen, welche Module die meisten Bugs enthalten. Fehlerdichte sagt Ihnen, wie viele Bugs ein Modul für seine Größe hat.
Aspekt
Fehlerclustering
Fehlerdichte
Frage, die es beantwortet
Welche Module enthalten die meisten Defekte?
Wie fehleranfällig ist dieses Modul für seine Größe?
Definition
Die meisten Defekte konzentrieren sich in wenigen Modulen.
Defekte pro Codeeinheit, z.B. pro KLOC oder Function Point.
Hauptverwendung
Entscheidung, wohin Testaufwand geht.
Qualitätsvergleich zwischen Modulen oder Releases.
Beispiel
80% der Bugs kommen aus 3 von 20 Modulen.
Modul A hat 10 Defekte pro 1.000 Codezeilen.
Benötigte Daten
Defektzählungen pro Modul.
Defektzählungen plus Codegröße.
Verwenden Sie Clustering, um zu entscheiden, wohin das Testen geht. Verwenden Sie Dichte, um zu entscheiden, ob ein Modul ein Rewrite oder nur mehr Abdeckung braucht. Ein kleines Modul kann schreckliche Dichte und eine niedrige Bug-Anzahl haben. Ein riesiges zentrales Modul kann milde Dichte haben und trotzdem Ihr größter Cluster sein, einfach weil so viel von der App dadurch läuft.
Wie Fehlerclustering QA-Teams hilft
Fehlerclustering hilft QA-Teams, begrenzte Zeit für die Module aufzuwenden, die den meisten Schaden verursachen. Anstatt jedes Feature gleichmäßig abzudecken, setzen Sie Tester, Scripts und Review-Zeit dort ein, wo Bugs tatsächlich auftreten.
Es gibt Ihnen auch eine direkte Antwort, wenn jemand fragt, was Ihr größtes Risiko ist. Sie können sagen, Modul X verursachte 65% der kritischen Defekte über die letzten drei Releases. Das ist viel einfacher zu verteidigen in der Planung als ein Bauchgefühl, und es macht zusätzliches Testen oder ein Refactoring zu einem leichteren Verkauf.
Regressionstests verbessern sich auch. Ein Modul ohne Bugs seit Monaten braucht einen Smoke-Test. Ein bekannter Hotspot braucht die vollständige Suite jedes Mal, wenn jemand es anfasst.
Entwickler reagieren besser auf diese Daten als auf Beschwerden. Ihnen zu zeigen, dass zwei Features 75% der Produktionsbugs produzieren, macht es zu einem gemeinsamen Problem, und die Konversation bewegt sich zu Grundursachen wie technischer Schuld oder fehlenden Unit-Tests.
Fehlerclustering im manuellen Testen funktioniert genauso. Ein manueller Tester, der weiß, welche Module sich schlecht benehmen, kann explorative Zeit dort verbringen, statt sie gleichmäßig über die App zu verteilen. Das zählt am meisten kurz vor einem Release, wenn nie genug Zeit ist, alles abzudecken. Es funktioniert nur, wenn die zugrunde liegenden Daten sauber sind, also halten Sie eine solide Bug Reporting-Gewohnheit aufrecht. Teams, die in Sprints arbeiten, können agile Reporting-Tools verwenden, um Modul-Tags konsistent zu halten.
Wie man Fehlerclustering im Softwaretest anwendet
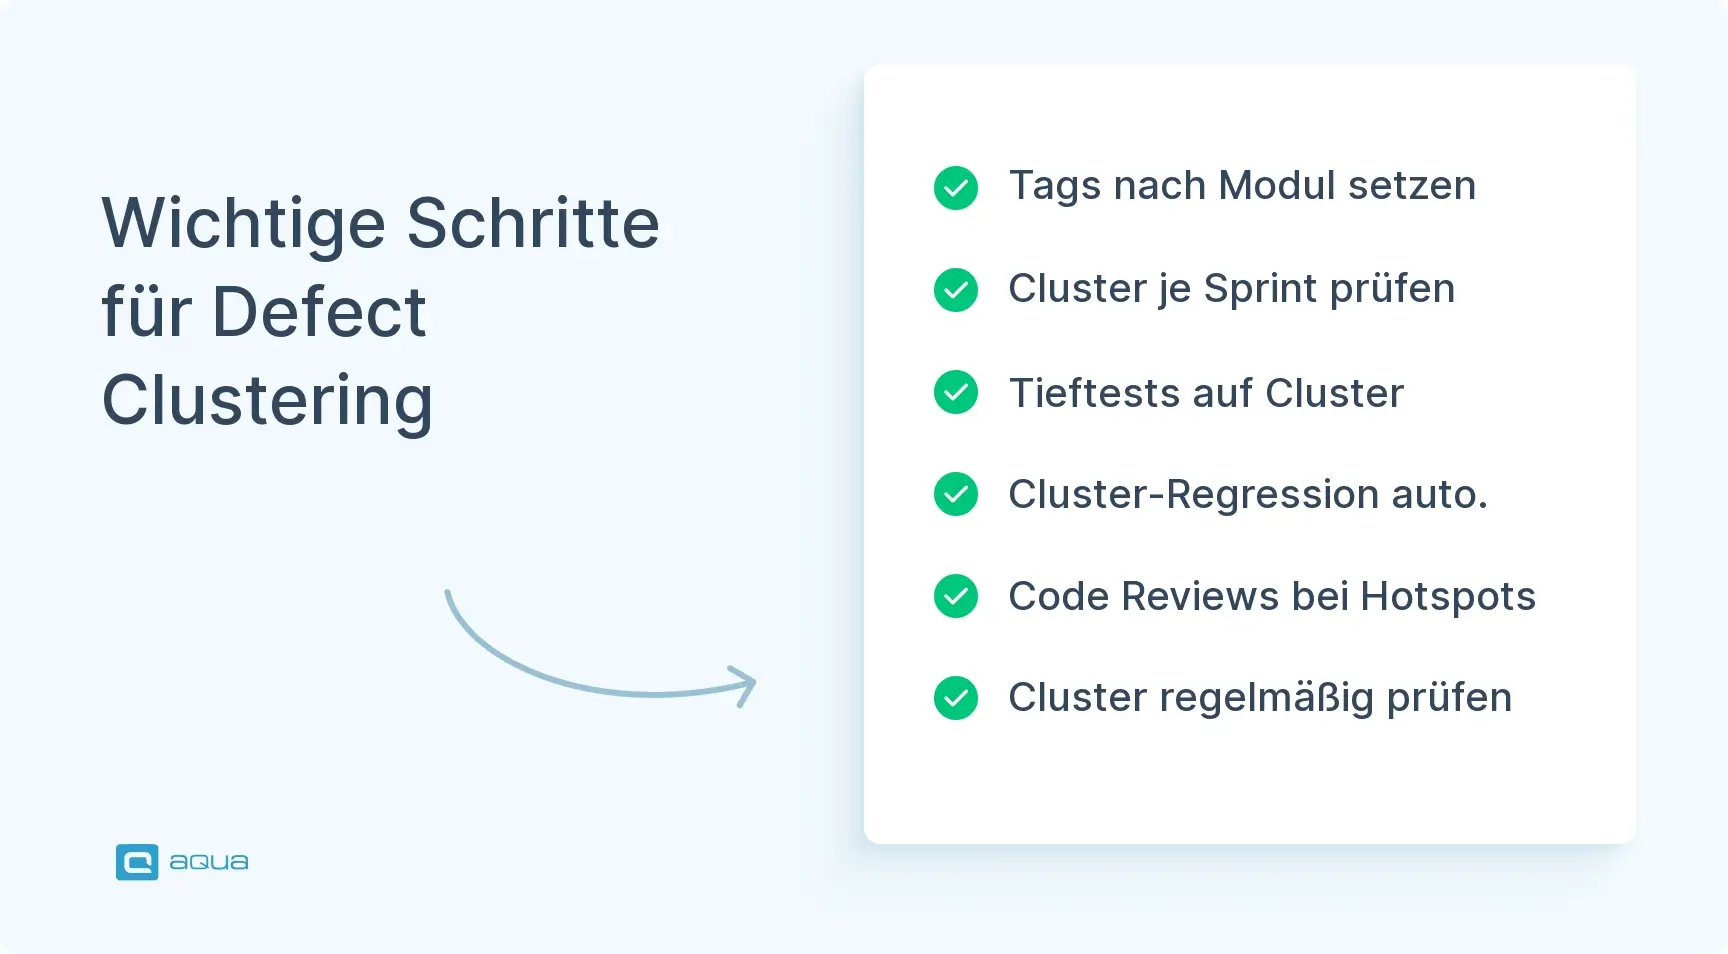
Beginnen Sie damit, Ihre vergangenen Defekt-Logs nach Modul zu sortieren. Wenn das Tagging noch nicht eingerichtet ist, richten Sie es zuerst ein, denn jeder Schritt unten hängt von sauberen Daten ab. Arbeiten Sie dann diese Schritte durch:
Schreiben Sie tiefere Testfälle für geclusterte Module – Wenn Checkout ein Cluster ist, testen Sie Fehlerzustände und Integrationspunkte, nicht nur den Happy Path.
Fügen Sie dort exploratives Testen hinzu – Setzen Sie Ihre erfahrensten Tester ohne Script in diese Module. Sie werden finden, was geskriptete Tests übersehen.
Automatisieren Sie Regression für Cluster zuerst – Diese Module brechen oft, also zahlt sich Automatisierung schnell aus. Ein Feature zu automatisieren, das niemand anfasst, tut es nicht.
Fügen Sie Code-Review und Pair-Programming für geclusterten Code hinzu – Ein zweites Augenpaar fängt Bugs, bevor sie QA erreichen.
Führen Sie die Analyse jeden Sprint erneut durch – Cluster lösen sich nach Fixes auf und neue erscheinen, also muss Ihr Fokus ihnen folgen.
Zeigen Sie die Daten den Stakeholdern – Ein Chart oder eine Heatmap in einer Retro macht das Risiko sichtbar und hilft Ihnen, Zeit für Tests oder Refactoring zu bekommen.
Fehlerclustering im risikobasierten Testen
Fehlerclustering füttert risikobasiertes Testen, indem es zeigt, wo Fehler am wahrscheinlichsten sind, was die Hälfte jeder Risikokalkulation ist. Die andere Hälfte ist Impact: wie sehr es dem Business schadet, wenn dieses Modul ausfällt.
Setzen Sie beides in eine einfache Matrix. Ein Cluster, der Zahlungen oder Kundendaten verarbeitet, ist hohe Wahrscheinlichkeit und hoher Impact, so bekommt es die schwerste Abdeckung: automatisierte Regression und explorative Sessions zusätzlich zu Performance- und Security-Checks. Ein Admin-Report, der von drei Personen genutzt wird, hat möglicherweise genauso viele Bugs, aber ein Ausfall dort kostet wenig, also bekommt er weniger Aufmerksamkeit. Dieser Trade-off ist, worum es beim risikobasierten Testen geht, und Clustering macht es konkret.
Es hilft Ihnen auch zu sehen, was kommt. Ein Modul, das vier Releases lang ein Hotspot war, wird wahrscheinlich einer für das fünfte sein, es sei denn, jemand refaktoriert es. Wenn ein Stakeholder dort ein Feature hinzufügen will, können Sie darauf hinweisen, dass das Modul bereits die Hälfte Ihrer kritischen Bugs verursacht, und zuerst um Refactoring-Zeit bitten.
Fehlerclustering im Regressionstest
Fehlerclustering sagt Ihnen, welche Module die schwerste Regressionsabdeckung brauchen. Regression ist teuer, und alles bei jeder Änderung zu laufen, verbrennt einen Sprint, bevor Sie fertig sind.
Module, die vorher geclustert waren, brechen eher wieder, wenn sie angefasst werden. Sagen wir, zwei der drei Features im nächsten Sprint-Scope sind bekannte Cluster. Führen Sie die vollständige Regressionssuite bei diesen zwei aus und einen Smoke-Test beim dritten.
Automatisierung folgt der gleichen Regel. Ein automatisierter Test zahlt sich nur aus, wenn das Modul, das er abdeckt, tatsächlich bricht. Automatisieren Sie die Cluster zuerst und lassen Sie Ihre CI-Pipeline diese Tests bei jedem Build laufen.
Nach einem Deployment fängt ein schneller Smoke-Test der gesamten App offensichtliche Brüche. Sparen Sie die tiefe Regressionsarbeit für die Cluster. Wenn der Release-Tag nah ist und die Zeit knapp, gehört sie dorthin.
Tools zur Analyse von Fehlerclustern
Sie können Fehlercluster mit Tools analysieren, die Sie wahrscheinlich bereits verwenden. Eine Tabellenkalkulation reicht zum Start.
Jira-Dashboards – Erstellen Sie Filter, die Defektzählungen nach Komponente oder Label zeigen, dann exportieren Sie die Daten für einen näheren Blick.
Ein Defect-Tracking-Tool – Ein dediziertes Defect Tracking Tool, das Bugs nach Modul taggt und sie mit Testfällen verknüpft, gibt Ihnen die Cluster-Ansicht ohne manuelle Exports.
TestRail oder Qase – Beide verknüpfen Testfälle mit Defekten und zeigen, welche Module die meisten fehlschlagenden Tests haben, was eng mit Clustern korreliert. Qase bietet auch Analytics-Dashboards.
Excel oder Google Sheets – Exportieren Sie die Daten, erstellen Sie eine Pivot-Tabelle und chartern Sie ein Pareto. Sie sehen Ihre Cluster in fünf Minuten.
Tableau oder Power BI – Live-Dashboards, die Sie nach Schweregrad, Modul oder Release slicen können. Overkill für ein kleines Team, nützlich im großen Maßstab.
GitHub Issues oder GitLab – Labels kategorisieren Bugs, und ein kurzes Python-Script mit der API kann Zählungen pro Label für Charting in matplotlib ziehen.
SonarQube – Es trackt technische Schuld nach Modul, und hohe Schuld sagt oft voraus, wo Bugs als nächstes clustern werden.
Welches Tool Sie wählen, zählt weniger als es jeden Sprint zu prüfen.
Vorteile von Fehlerclustering
Testzeit geht, wohin sie zählt – Stabiler Code hört auf, Stunden zu fressen, die er nicht braucht.
Bugs tauchen schneller auf – Tester graben in bekannte Schwachstellen statt durch die ganze App zu wandern.
Risikogespräche werden einfacher – Sie können Zahlen zeigen statt Meinungen.
Automatisierungsbudget geht weiter – Sie automatisieren die Module, die am meisten brechen.
Dev und QA arbeiten zusammen an Grundursachen – Die Daten zeigen auf das Problem, nicht auf eine Person.
Verbesserung wird sichtbar – Ein Hotspot, der nach einem Refactoring ruhig wird, beweist, dass die Arbeit sich ausgezahlt hat.
Einschränkungen von Fehlerclustering
Es sieht nur die Vergangenheit – Clustering reflektiert Bugs, die Sie bereits gefunden haben. Ein stabiles Modul kann nach einem Rewrite zum Hotspot werden, und die alten Daten warnen Sie nicht.
Schlechtes Tagging ruiniert es – Wenn Bugs nicht nach Modul getaggt sind, führen die Zahlen in die Irre. Saubere Daten kommen zuerst.
Null Bugs bedeutet nicht sauber – Ein Modul ohne Defekte ist möglicherweise einfach ungetestet, und Clustering kann Aufmerksamkeit davon wegziehen.
Ruhige Module sind nicht sicher – Ein seltener Bug in einem ruhigen Modul, wie Billing, kann immer noch eine Katastrophe sein.
Daten werden veraltet – Nach einem Refactoring oder einer getauschten Dependency bedeuten alte Cluster wenig.
Entwickler können sich herausgegriffen fühlen – Die in Hotspots arbeiten, können die Daten als Kritik lesen. Präsentieren Sie es als Systemproblem.
Behandeln Sie Clustering als einen Input. Paaren Sie es mit explorativem Testen und Code-Review. Wenn ein Cluster auftaucht, sagt Ihnen Debugging, warum er sich gebildet hat.
Best Practices für die Nutzung von Fehlerclustering
Taggen Sie jeden Defekt vom ersten Tag an nach Modul. Machen Sie es zu einem Pflichtfeld in Ihrem Tracker und erklären Sie, warum es zählt, damit Leute nicht einfach durchklicken. Ohne Tags bleiben Clustering-Daten unvollständig, egal wie gut Ihre Analyse ist.
Setzen Sie die Daten dorthin, wo Leute bereits schauen. Eine Tabellenkalkulation in einem Shared Drive wird ignoriert. Ein Chart im Team-Slack-Channel oder am Sprint-Board wird gelesen.
Paaren Sie die Zahlen mit Gesprächen. Die Daten zeigen, wo die Cluster sind, und die Entwickler, die in diesem Code arbeiten, können Ihnen sagen, warum. Die echte Grundursache kommt normalerweise aus diesem zweiten Teil.
Führen Sie die Analyse jeden Sprint oder Release erneut durch und aktualisieren Sie Ihren Testplan, wenn sich das Bild ändert. Ein Cluster, den Sie letztes Quartal gefixt haben, sollte nicht immer noch die Prioritäten dieses Quartals treiben.
Rahmen Sie Hotspots als Systemprobleme. Komplexität, technische Schuld und dünne Testabdeckung verursachen sie, und einen Entwickler zu beschuldigen, fixt nichts davon.
Halten Sie exploratives Testen neben Clustering am Laufen. Cluster zeigen, wo Bugs waren. Exploration findet die, von denen Sie nicht wussten, dass Sie suchen sollten.
Fehlerclustering vs. andere Softwaretest-Prinzipien
Fehlerclustering ist eines von sieben Standard-Test-Prinzipien. So verhält es sich zu den anderen:
Prinzip
Definition
Beziehung zu Fehlerclustering
Fehlerclustering
Die meisten Defekte konzentrieren sich in wenigen Modulen.
Leitet, wo Tests fokussiert werden sollen.
Pestizid-Paradoxon
Dieselben Tests wiederholen findet mit der Zeit weniger neue Bugs.
Fokus auf Cluster, aber erneuern Sie diese Tests regelmäßig.
Testen zeigt Vorhandensein von Defekten
Testen beweist, dass Bugs existieren, nie, dass keine bleiben.
Clustering findet Bugs schneller, kann aber keine Null versprechen.
Erschöpfendes Testen ist unmöglich
Sie können nicht jeden Input und Pfad testen.
Clustering ist die praktische Antwort: Testen Sie, wo das Risiko am höchsten ist.
Frühes Testen
Frühes Testen macht Defekte billiger zu fixen.
Daten aus frühen Builds zeigen, wo Cluster sich bilden werden.
Testen ist kontextabhängig
Strategie sollte zum Projekt passen.
Eine SaaS-App und ein eingebettetes System clustern unterschiedlich.
Fehlen von Fehlern Trugschluss
Ein fehlerfreies Produkt kann seine Benutzer trotzdem enttäuschen.
Clustering findet technische Defekte, nicht unerfüllte Bedürfnisse.
Clustering funktioniert am besten neben diesen Prinzipien, nicht anstelle von ihnen. Es schärft, wohin Sie schauen, aber ersetzt nicht frühes Testen oder Exploration.
Fehlerclustering-Checkliste für QA-Teams
Taggen Sie jeden Defekt nach Modul oder Komponente und machen Sie das Feld erforderlich.
Führen Sie eine Clustering-Analyse am Ende jedes Sprints oder Releases durch.
Finden Sie die Top-20% der Module, die die meisten Ihrer Defekte enthalten.
Berechnen Sie die Fehlerdichte für diese Module, um zu sehen, wie schwer sie für ihre Größe sind.
Schreiben Sie tiefere Testfälle und fügen Sie explorative Sessions für jeden Cluster hinzu.
Automatisieren Sie Regression für die höchsten Risiko-Cluster zuerst.
Planen Sie Code-Reviews oder Pair-Programming für geclusterten Code.
Verfolgen Sie, wie Cluster sich über Zeit ändern, und passen Sie den Testplan entsprechend an.
Teilen Sie die Erkenntnisse mit Entwicklern und Product Managern mithilfe einfacher Charts.
Halten Sie exploratives Testen in Niedrig-Defekt-Bereichen am Laufen, damit sie nicht zu blinden Flecken werden.
Nutzen Sie die Daten, um für Refactoring in Modulen zu argumentieren, die Hotspots bleiben.
Sprechen Sie über Cluster als Systemprobleme, nicht individuelle Fehler.
Überprüfen Sie den gesamten Prozess jedes Quartal, um zu prüfen, dass Tagging und Kadenz noch funktionieren.
Sie haben gelernt, wie die Fehlerclusterbildung funktioniert, wie man sie erkennt und wie man sie strategisch einsetzt. Jetzt ist es an der Zeit, diese Prinzipien mit Tools in die Praxis umzusetzen, die die Clusteranalyse zum Kinderspiel machen. aqua cloud bietet Ihnen alles, was Sie benötigen, um Fehlermuster in Echtzeit zu verfolgen, zu visualisieren und darauf zu reagieren. Erstellen Sie anpassbare Dashboards, die die Fehlerverteilung über Module hinweg aufzeigen, richten Sie KPI-Warnmeldungen ein, die Sie benachrichtigen, wenn Hotspots auftreten, und nutzen Sie umfassende Berichte, um Risiken gegenüber den Beteiligten souverän zu kommunizieren. Dank der durchgängigen Rückverfolgbarkeit von aqua wird jeder Fehler automatisch mit Testfällen und Anforderungen verknüpft, sodass Sie den Kontext erhalten, den Sie benötigen, um nicht nur zu verstehen, wo Cluster auftreten, sondern auch warum. Und wenn es darum geht, Ihre Testbemühungen auf diese kritischen Hotspots zu konzentrieren, generiert die domänenspezifisch trainierte KI von aqua (aqua Intelligence) – die sich mittels RAG-Technologie auf die projektinterne Dokumentation stützt – gezielte Testfälle, die die Sprache Ihrer Codebasis sprechen, und hilft Ihnen so, in Bereichen mit hohem Risiko eine Abdeckung von bis zu 100 % zu erreichen. aqua vereint intelligentes Fehlermanagement, nahtlose Jira-Integration, KI-gestützte Testgenerierung und Analysen, die Ihre Entscheidungen tatsächlich leiten.
Cluster identifizieren, intelligenter priorisieren und 98 % des manuellen Testaufwands eliminieren
Fehlerclustering im Softwaretest klingt offensichtlich, sobald Sie es sehen. Bugs sammeln sich in komplexen Modulen, in Code, der sich ständig ändert, und in Features, die auf externe Systeme angewiesen sind. Die Teams, die dies bemerken und darauf reagieren, verbringen ihre Zeit dort, wo es zählt.
Clustering gibt Ihnen Beweise für diese Entscheidungen. Sie können Ihr größtes Risiko mit Zahlen erklären, Entwickler auf die echten Grundursachen hinweisen und Stakeholdern zeigen, warum ein Modul ein Refactoring braucht. Es sagt Ihnen nicht, was noch nicht kaputt gegangen ist, also erkunden Sie auch weiter die ruhigen Teile der App. Ziehen Sie diese Woche Ihre Defekt-Daten und sehen Sie, welche Module oben herauskommen.
Fehlerclustering ist das Muster, bei dem wenige Module oder Features für die meisten Defekte einer Anwendung verantwortlich sind, oft 70 bis 90% davon. Es folgt derselben Form wie die 80/20-Pareto-Regel. Es sagt QA-Teams, wo sie Tests fokussieren sollen, anstatt den Aufwand gleichmäßig zu verteilen.
Was ist ein Beispiel für Fehlerclustering im Softwaretest?
Login ist das klassische Beispiel. OAuth, Session-Handling und Token-Ablauf interagieren alle, sodass Authentifizierung oft einen unverhältnismäßigen Anteil kritischer Bugs produziert. Zahlungs- und Checkout-Flows zeigen dasselbe Muster, weil Währungsumrechnung, Rabattlogik und Gateway-Timeouts jeweils eigene Fehlerpunkte hinzufügen.
Wie verhält sich das Pareto-Prinzip zu Fehlerclustering?
Das Pareto-Prinzip ist die statistische Idee hinter Fehlerclustering. Es besagt, dass etwa 80% der Effekte aus 20% der Ursachen kommen, was im Testen bedeutet, dass etwa 80% der Defekte aus 20% der Module kommen. Die exakte Aufteilung variiert je nach Projekt, aber ein kleiner Teil des Systems, der das meiste Risiko trägt, taucht konsistent auf.
Wie können QA-Teams Fehlercluster identifizieren?
Exportieren Sie Defekte aus Ihrem Tracker, taggen Sie sie nach Modul und chartern Sie die Zählungen mit einem Balken- oder Pareto-Diagramm. Berechnen Sie dann die Fehlerdichte, damit große und kleine Module fair verglichen werden. Fragen Sie Entwickler und Support, welche Bereiche die meisten Probleme verursachen, da das oft Cluster offenbart, die die Zahlen noch verfehlt haben.
Was sind die Vorteile und Einschränkungen von Fehlerclustering im Softwaretest?
Die Hauptvorteile sind bessere Nutzung der Testzeit, schnellere Bug-Erkennung, klarere Risikogespräche und intelligentere Automatisierungsentscheidungen. Die Haupteinschränkungen sind, dass es nur vergangene Defekte reflektiert und Risiko in ungetesteten Modulen verbergen kann, die wenige Bugs zeigen. Verwenden Sie es neben explorativem Testen und Code-Review, nicht als einzige Strategie.
Nurlan, ein QA-Koordinator, ist stolz darauf, nahtlose QA-Operationen zu orchestrieren. Seine Expertise in der Koordination von QA-zentrierten Projekten und der Integration von QA-Lösungen hat konsequent höchste Kundenzufriedenheit erzielt. Neben seiner Vollzeittätigkeit als QA-Koordinator beinhaltet Nurlans Rolle das Erstellen von überzeugenden Inhalten, die Nutzer über die…
Die Verbesserung des aqua-Produkts ist Martins Hauptaufgabe und größte Mission. Sein Fachwissen umfasst ITIL-Prozessberatung, Änderungsmanagement, Qualitätssicherung, Qualitätsmanagement und Anforderungsmanagement. Martin arbeitet seit mehr als 18 Jahren in der Qualitätssicherung für regulierte Branchen und ist eine unersetzliche Führungskraft bei der andagon Group.
Beginnen Sie Ihre Arbeit nicht mit gewöhnlichen E-Mails: Fügen Sie eine gesunde Dosis an aufschlussreichen Softwaretest-Tipps von unseren QS-Experten hinzu.
Home » Testautomatisierung » Fehlerclustering im Softwaretest: Was es ist und wie es funktioniert
Lieben Sie das Testen genauso wie wir?
Werden Sie Teil unserer Community von begeisterten Experten! Erhalten Sie neue Beiträge aus dem aqua-Blog direkt in Ihre Inbox. QS-Trends, Übersichten über Diskussionen in der Community, aufschlussreiche Tipps — Sie werden es lieben!
Wir sind dem Schutz Ihrer Privatsphäre verpflichtet. Aqua verwendet die von Ihnen zur Verfügung gestellten Informationen, um Sie über unsere relevanten Inhalte, Produkte und Dienstleistungen zu informieren. Diese Mitteilungen können Sie jederzeit wieder abbestellen. Weitere Informationen finden Sie in unserer Datenschutzrichtlinie.
X
🤖 Neue spannende Updates sind jetzt für die aqua-Intelligenz verfügbar! 🎉